En grøn testsuite siger ikke om AI-systemet løser opgaven
En sagsbehandler i en a-kasse spørger en AI-assistent om et medlem har ret til dagpenge fra 1. marts. Svaret kan være flydende, korrekt formateret og forkert. Ingen klassisk softwaretest opdager det.
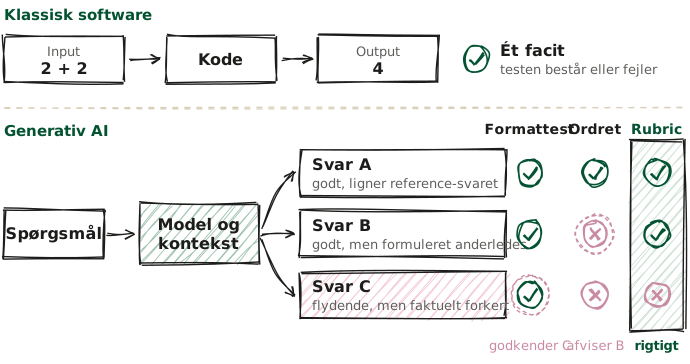
En klassisk test har ét facit: Givet et bestemt input forventer vi et bestemt output, og testen består eller fejler. Generativ AI har ikke ét facit. To forskellige svar kan begge være gode, og et velformuleret svar kan være faktuelt forkert. En test der sammenligner ordret med et reference-svar, kasserer det gode svar med en anden formulering. En formattest godkender det forkerte.
Den disciplin vi bruger i stedet, kalder vi EvalOps: definér hvad godt betyder, test det systematisk, styr udviklingen efter resultaterne og bliv ved efter go-live. Hele metoden står i vores white paper Kvalitetssikring af AI kræver mere end test. I praksis ligger det meste af værdien i fem greb.
Succes defineres i arbejdsgangen
Den vigtigste måling er sjældent en generisk score som faithfulness eller answer relevance. Den afhænger af opgaven. For en mødeassistent er det om alle beslutninger kommer med i referatet, og om der står noget som aldrig blev sagt. For en agent der skal booke et møde, er det om mødet bliver booket. For sagsbehandling er det om hver sætning i svaret peger på det præcise afsnit den bygger på.
Rækkefølgen gør også evalueringen forståelig for dem der ejer arbejdsgangen. En afdelingschef behøver ikke vide hvad faithfulness er, for at kunne sige at et svar uden kildehenvisning ikke kan bruges. Den sætning er et succeskriterium, og den kan måles.
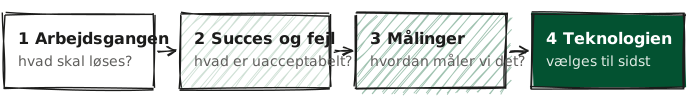
»Den vigtigste måling er sjældent en generisk score. Den afhænger af opgaven.«
Tre til fem målinger er som regel nok: en eller to der er specifikke for opgaven, og to eller tre der følger arkitekturen. Flere målinger giver et dashboard ingen handler på.
Evalsættet skal indeholde det der går galt
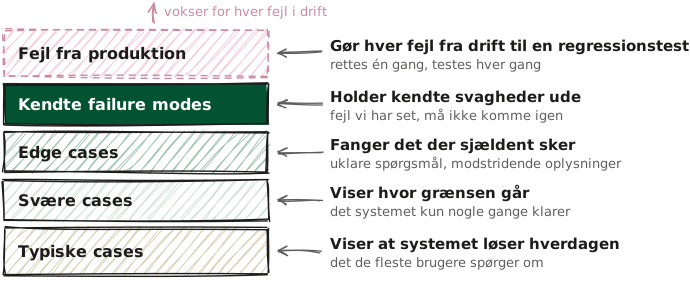
Et evalueringsdatasæt der kun indeholder de spørgsmål systemet allerede svarer rigtigt på, måler ingenting. Det skal også rumme svære cases, edge cases og kendte failure modes: uklare spørgsmål, modstridende oplysninger og spørgsmål uden svar i vidensbasen.
Hver fejl der dukker op i drift, føjes til sættet. Så bliver den ikke bare rettet én gang. Den bliver en regressionstest der fanger den hvis den kommer tilbage.
Datasættet versioneres sammen med systemet. En score hører til en bestemt version af sættet, og to scores målt på forskellige versioner kan ikke sammenlignes direkte.
Uden komponentmålinger ved du ikke hvad der skal rettes
Når en RAG-løsning giver et forkert svar, kan fejlen ligge tre steder. Søgningen fandt aldrig det relevante dokument. Den fandt det, men irrelevante tekststykker blev prioriteret højere. Eller modellen fik den rigtige kontekst og skrev alligevel noget den ikke bar.
Slutresultatet er det samme forkerte svar i alle tre tilfælde. Rettelsen er forskellig: anden chunking eller flere søgeresultater i det første, en reranker i det andet, prompt og krav om kildehenvisning i det tredje. Kun målinger på komponentniveau kan skelne dem: context recall, context precision og faithfulness.
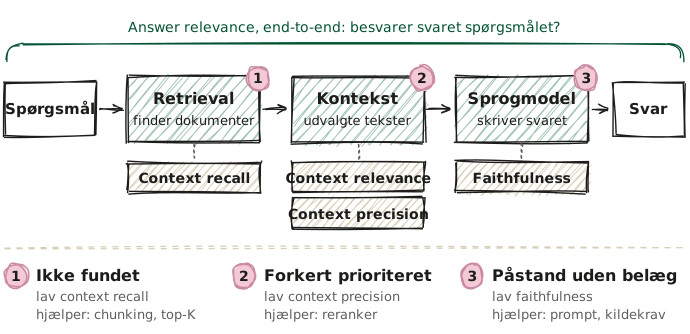
End-to-end-evaluering fortæller hvad der går galt. Komponenterne fortæller hvor. For agenter gælder det samme: Tool correctness viser om agenten brugte de rigtige værktøjer, og task completion viser om opgaven faktisk blev løst. Korrekte trin er ikke det samme som en løst opgave.
En AI-dommer skal kalibreres før den må dømme
De fleste kvalitetsspørgsmål i generativ AI kan ikke afgøres med pass/fail. Der findes ikke ét korrekt resumé. Derfor lader vi en anden sprogmodel vurdere svarene efter en klart defineret rubric. Det gør det muligt at evaluere langt flere svar ved hver ændring, end et menneske kan nå.
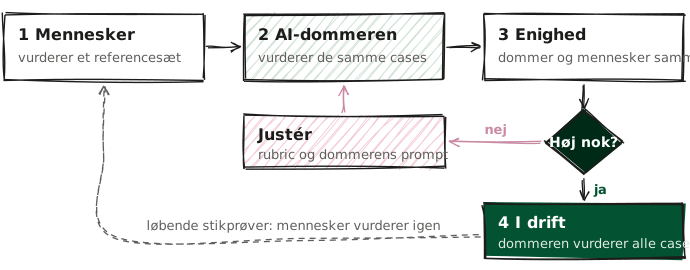
Men dommeren er selv en sprogmodel. Dens vurderinger kan flytte sig med formuleringen af kriterierne og med den rækkefølge svarene præsenteres i. Derfor vurderer mennesker først et referencesæt, og vi måler om dommeren er enig med dem. Først når enigheden er høj nok, kører dommeren på alle cases, og målingen gentages hver gang dommerens model eller prompt ændres.
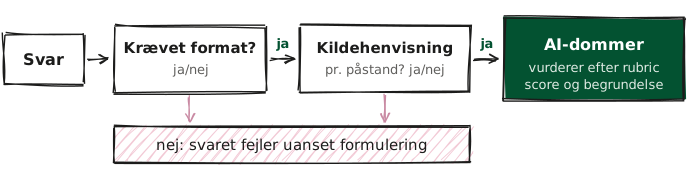
Hårde krav afgøres før dommeren overhovedet ser svaret, med deterministiske ja/nej-tjek: Har svaret det krævede format? Har hver påstand en kildehenvisning? Et svar uden kildehenvisning fejler uanset hvor godt det i øvrigt er formuleret.
Evals er en quality gate, også efter go-live
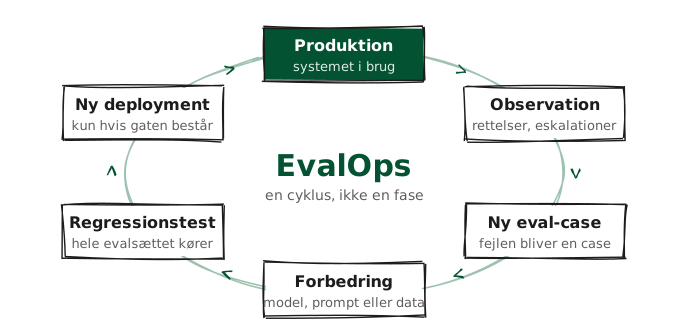
Den egentlige værdi kommer når evalsættet kører automatisk hver gang nogen ændrer model, prompt, retrieval, chunking eller agentlogik. Falder en kritisk måling under det aftalte niveau, stoppes deploymentet, på samme måde som en build stoppes af fejlede tests. Tærsklen sættes pr. måling og pr. use case, efter hvad en fejl koster i den konkrete arbejdsgang.
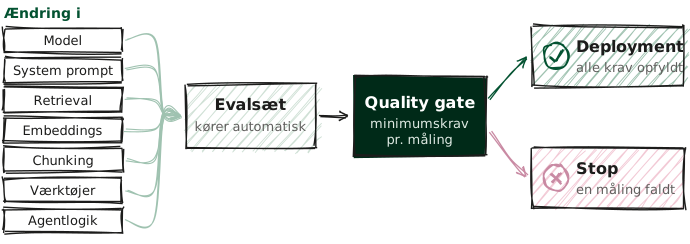
Det ændrer samtalen i teamet.
Den nye model virker umiddelbart bedre.
Den nye konfiguration forbedrer task completion, holder minimumskravet til faithfulness og reducerer latency.
Evalueringen stopper ikke ved go-live. Brugerne finder nye anvendelser, datagrundlaget ændrer sig, og eksterne modeller kan skifte adfærd uden at nogen har rørt systemet. Rettelser, overrides og eskalationer til mennesker er de mest ærlige kvalitetssignaler vi har. De vigtigste af dem bliver nye cases i evalsættet.
Den vigtigste måling ligger i arbejdsgangen
En højere faithfulness-score er ikke det samme som mere produktive medarbejdere. En agent kan løse flere opgaver korrekt og samtidig skabe så meget kontrolarbejde at den samlede proces bliver langsommere. Tekniske målinger er leading indicators. De skal løbende holdes op mod det der sker i arbejdsgangen, og stiger scoren uden at arbejdsgangen bliver bedre, måler vi det forkerte.
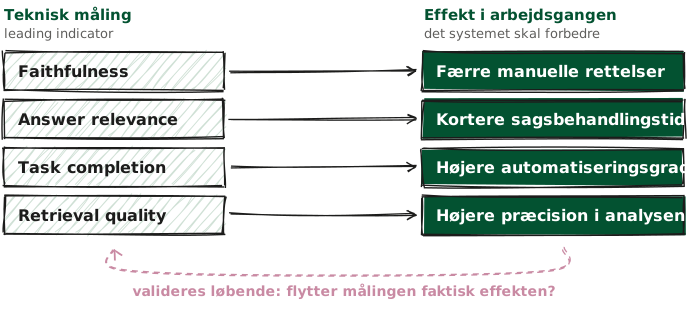
I en løsning vi har udviklet til a-kassesektoren, er den tekniske måling at hvert svar peger på paragrafgrundlaget. Effekten i arbejdsgangen er at antallet af manuelle lovopslag pr. sag ligger på 0–1. I en leverance til forsikrings- og pensionsbranchen trækker vi forsikringsdata ud med cirka 98 % præcision til Open Finance og FiDA. De sidste 2 % bliver ikke gemt væk, fordi et system der ikke kan sige hvor det er usikkert, ikke kan bruges til noget med retsvirkning.
- 0–1
- manuelle lovopslag pr. sag i en løsning til a-kassesektoren. Den tekniske måling er kildehenvisningen til paragrafgrundlaget.
- ca. 98 %
- præcision på forsikringsdata i en leverance til forsikrings- og pensionsbranchen, til brug for Open Finance og FiDA.
For systemer der klassificeres som højrisiko efter AI-forordningen, er det her ikke kun god praksis. Forordningen kræver test mod forud definerede metrikker og tærskler, automatisk logning og systematisk overvågning efter ibrugtagning. En organisation der allerede måler kvalitet systematisk, har dokumentationen klar når tilsynet spørger.
Det enkleste sted at begynde er én test: Kan I køre den samme evaluering igen i morgen og få et tal I kan sammenligne med dagens? Hvis ikke, har I en vurdering og ikke en måling.